Файл: Організація віртуальної пам’яті в процесорах сімейства Nehalem.rtf
Добавлен: 02.09.2026
Просмотров: 14
Скачиваний: 0
Організація віртуальної пам’яті в процесорах сімейства Nehalem
Вступ
Політика компанії Intel у відношенні до настільних процесорів полягає в щорічному поновленні продуктової лінійки. Це здійснюється двома способами - переходом на новий технологічний процес та зміною архітектури. В 2008 році підійшла черга зміни архітектури і Intel представила свою останню розробку - Nehalem.
Перед нами чергова революційна платформа, яка может підняти планку продуктивності на ще більший рівень. Nehalem - нова мікроархітектура для процесорів Bloomfield у виконанні LGA 1366, а також для процесорів Lynnfield у виконанні LGA 1156. Мікропроцесори продаються під торговою маркою Core i7 і Core i5.
Технологія обробки віртуальної пам’яті в процесорах розроблена для багатозадачних операційних систем. При використанні даної технології для кожної програми використовуються незалежні схеми адресації пам'яті, які відображаються тим або іншим способом на фізичні адреси в пам'яті ЕОМ. Дозволяє збільшити ефективність використання пам'яті декількома одночасно працюючими програмами, організувавши безліч незалежних адресних просторів і забезпечити захист пам'яті між різними додатками. Також дозволяє програмісту використовувати більше пам'яті, ніж встановлено в комп'ютері, за рахунок відкачування не використовуваних сторінок на вторинне сховище (див. Підкачка сторінок).
При використанні віртуальної пам'яті спрощується
програмування, так як програмісту більше не потрібно враховувати обмеженість
пам'яті, або погоджувати використання пам'яті з іншими додатками. Для програми
виглядає доступним і безперервним все допустиме адресний простір, поза
залежністю від наявності в ЕОМ відповідного обсягу ОЗУ.
Постановка завдання
Тема моєї курсової роботи "Організація віртуальної пам’яті в процесорах сімейства Nehalem". Мета курсової роботи - вдосконалення теоретичних знань.
Для більш детального розгляду цієї теми необхідно розглянути такі питання:
. Архітектура Intel Core i (Nehalem) та її особливості
. Технічні характеристики процесорів
.1 Intel Core i3
.2 Intel Core i5
.3 Intel Core i7
. Організація віртуальної пам’яті в процесорах Intel
1. Загальна частина
.1 Архітектура Nehalem
Корпорація Intel уперше представила мікроархітектуру Nehalem в листопаді 2008 року. Процесори грунтувалися на мікроархітектурі Nehalem, вироблялися за технологією - 45 нм, містили 731 млн. транзисторів у ядрі, три рівня КЕШ-пам'яті (L3 КЕШ - 8 Мб, з технологією Smart Cache), вбудований контролер пам'яті, що підтримує пам'ять DDR3-800/1066 до 24 Гб, і встановлювалися в роз'єм LGA 1366. Працювали на тактовій частоті - 2,67-3,33 ГГц (з технологією Turbo Boost 2,93-3,6 ГГц), з шиною QPI.
У процесорах використовувалися технології та набори інструкцій: MMX, SSE, SSE2, SSE3, SSSE3, SSE4.1, SSE4.2, Enhanced Intel SpeedStep Technology, Intel 64, XD bit, Intel VT-x, Hyper-threading, Turbo Boost, Smart Cache.
Це були перші процесори, створені на основі нової мікроархітектури Nehalem. В процесори було внесено цілий ряд принципових змін. По-перше, було розроблено нове обчислювальне ядро, що базується на обчислювальному ядрі Core, але з низкою змінених або оптимізованих блоків, і на новій системній шині, в сукупності дозволили ядер процесора безпосередньо обмінюватися даними між собою. При цьому максимальна пропускна здатність системної шини становила 25.6 Гб в секунду.
По-друге, в процесори був інтегрований трьохканальний контролер пам'яті, що дозволяє значно підняти продуктивність, за рахунок скорочення затримок, пов'язаних з роботою з пам'яттю.
По-третє, серйозної переробки піддалася КЕШ-пам'ять. В результаті, КЕШ-пам'ять другого рівня стала індивідуальною для кожного ядра, і її обсяг зменшився до 256 Кб, а КЕШ-пам'ять третього рівня стала загальною для всіх ядер, при цьому за допомогою технології Smart Cache розмір КЕШ-пам'яті третього рівня, відведеної конкретному ядру, змінювався, залежно від навантаження на ядро.
Був ще цілий ряд менш принципових змін. У сукупності всі інновації дозволили значно підняти продуктивність процесора навіть без зміни тактової частоти, яка також була немаленькою і досягала 3,33 ГГц, а з технологією Turbo Boost, що дозволяє короткочасно, при підвищенні навантаження на ядро, підвищувати тактову частоту, досягала 3,6 ГГц . В цій архітектурі були використані різні сучасні інновації, що забезпечують рекордне підвищення продуктивності, поліпшення енергозбереження та підвищення швидкодії при роботі в багатозадачному середовищі.
Розібравшись з тим, які технології забезпечують підвищення
продуктивності процесорів Intel Core i7, можна переходити до знайомства зі
структурною схемою (рисунок 2.1), на якій відображені логічні особливості
обробки даних.
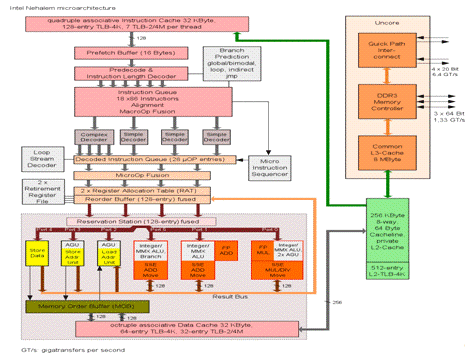
Рисунок 1.1.1 Архітектура Nehalem
Архітектура Intel Core передбачає симетричний декодер 4-4-4-4, тобто кожен з чотирьох каналів декодера може декодувати інструкції, що породжують до чотирьох мікрооперацій.
Більшість команд при декодуванні розбивається на дві-три мікрооперацій, однак зустрічаються і такі команди, для декодування яких потрібні були б десятки і навіть сотні мікрооперацій. Для цих цілей використовується спеціальна ROM-пам'ять (uCode ROM), в якій зберігаються програми, що складаються з послідовності мікрооперацій, причому кожна така програма відповідає одній декодованому інструкції.
Після процесу декодування команд починається етап їх виконання. Спочатку відбувається перейменування і розподіл додаткових регістрів процесора (Allocate & Rename), які не визначені архітектурою набору команд. Перейменування регістрів дозволяє домогтися їх безконфліктного існування.
На наступному етапі (Retirement Unit (ReOrder Buffer)) відбувається переупорядкування мікрооперацій не в порядку їх надходження (out of order) з тим, щоб згодом можна було реалізувати їх паралельне виконання на виконавчих блоках.
Далі відбувається планування та розподіл мікрооперацій за виконавчими блокам. Планувальник (Scheduler) формує черги мікрооперацій, в результаті чого мікрооперацій потрапляють на один з п'яти портів функціональних пристроїв (dispatch ports). Цей процес називається диспетчеризацією (Dispatch), а самі порти виконують функцію шлюзу до функціональних пристроїв.
Після того як мікрооперацій пройдуть порти диспетчеризації, вони завантажуються в блок регістрів для подальшого виконання.

В архітектурі Intel Core є три порти ALU для операцій з плаваючою комою (Float Point) (FMUL / FPMove, FADD / FPMove, Branch / FPMove), а також по одному порту для запису (Store) і вивантаження (Load) даних з пам'яті.
Крім арифметико-логічних та адресних функціональних пристроїв, в кожному процесорі є також пристрої завантаження і вивантаження (Store / Load), які здійснюють доступ до кешам даних і до оперативної пам'яті. Ці пристрої працюють асинхронно з іншими, і їх звичайно не зображують на блок-схемах.
Логічно дані пристрої зв'язані з пристроями обчислення адрес читання / запису (AGU). Пристрої завантаження і вивантаження конвеєризовані і можуть одночасно обслуговувати велику кількість запитів. Вони також здійснюють попередню вибірку з оперативної пам'яті (копіювання в кеші тих даних, використання яких очікується найближчим часом).
Процес безпосереднього виконання мікрооперацій у виконавчих пристроях відбувається на подальших ступенях конвеєра. Ефективна довжина конвеєра в архітектурі Intel Core становить 14 ступенів.
Нова технологія Turbo Boost дозволяє розподіляти продуктивність ПК в залежності від загрузки, та збільшувати тактову частоту процесору на 267 МГц від номінальної. Технологія автоматично збільшує тактову частоту процесора понад номінальною, якщо при цьому не перевищуються обмеження потужності, температури і струму в складі розрахункової потужності (TDP). Це призводить до збільшення продуктивності
Однопотокові і багатопоточних додатків. Фактично це технологія "саморазгона" процесора.
Доступність технології Turbo Boost не залежить від кількості
активних ядер, проте залежить від наявності одного або кількох ядер, що
працюють з потужністю нижче розрахункової. Час роботи системи в режимі Turbo
Boost залежить від робочого навантаження, умов експлуатації та конструкції
платформи.
1.2 Вбудований контролер пам'яті
включає цілих три контролера пам'яті DDR3. Якщо встановити
пам'ять DDR3-1333, яку Nehalem теж буде підтримувати, це дасть пропускну
спроможність до 32 Гбайт / с в деяких конфігураціях. Але перевага вбудованого
контролера пам'яті криється не тільки в пропускній спроможності. Він істотно
знижує затримки доступу до пам'яті, що не менш важливо, враховуючи, що кожен
доступ коштує кілька сотень тактів. У контексті настільного використання
зниження затримок вбудованого контролера пам'яті можна вітати, однак повну
перевагу від більш масштабованої архітектури буде помітно в многосокетних
серверних конфігураціях. Раніше при додаванні CPU доступна пропускна
спроможність залишалася колишньою, проте тепер кожен новий додатковий процесор
збільшує пропускну спроможність, оскільки кожен CPU володіє власною пам'яттю.
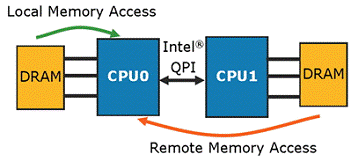
Рисунок 1.2.1 Вбудований контролер памяті
Звичайно, чудес чекати не слід. Перед нами конфігурація Non
Uniform Memory Access (NUMA), тобто доступ до пам'яті буде обходитися з тих чи
інших накладним розцінками, залежно від того, де дані розташовуються в пам'яті.
Зрозуміло, що доступ до локальної пам'яті буде проводитися з самими низькими
затримками і самої високою пропускною здатністю, оскільки доступ до віддаленої
пам'яті відбувається через проміжний інтерфейс QPI, що знижує продуктивність.
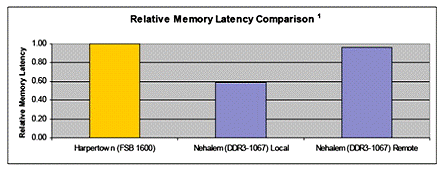
Вплив на продуктивність передбачити складно, оскільки все
залежить від програми та операційної системи. Intel стверджує, що падіння
продуктивності при віддаленому доступі по затримкам становить близько 70%, а
пропускна здатність знижується в два рази в порівнянні з локальним доступом. За
інформацією Intel, навіть при віддаленому доступі через інтерфейс QPI, затримки
будуть нижче, ніж на попередніх поколіннях процесорів, де контролер знаходився
на північному мосту. Однак це стосується тільки серверних додатків, які вже
досить тривалий час розробляються з урахуванням конфігурацій NUMA.
1.3 Трирівнева ієрархія кеша
сконцентрувалася на продуктивності загального кеша L2, який
став кращим рішенням для архітектури, яка націлювалася, головним чином, на
двоядерні конфігурації. Але у випадку з Nehalem інженери почали з нуля і
прийшли до такого ж висновку, що і конкуренти: загальний кеш L2 не дуже добре
підходить для "рідної" чотирьохядерний архітектури. Різні ядра можуть
занадто часто "вимивати" дані, необхідні іншим ядрам, що призведе до
занадто багатьом проблемам з внутрішніми шинами і арбітражем, намагаючись
забезпечити всі чотири ядра достатньою пропускною спроможністю із збереженням
затримок на досить низькому рівні. Щоб вирішити ці проблеми, інженери оснастили
кожне ядро власним кешем L2. Оскільки він виділений на кожне ядро і відносно
малий (256 кбайт), вийшло забезпечити кеш дуже високою продуктивністю; зокрема,
затримки істотно покращилися в порівнянні з Penryn - з 15 тактів до, приблизно,
10 тактів.
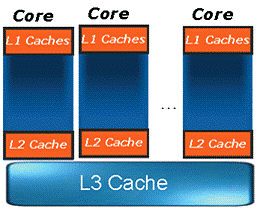
Рисунок 1.3.1 Трирівнева ієрархія кеша
Потім є величезна кеш-пам'ять третього рівня (8 Мбайт), що
відповідає за зв'язок між ядрами. На перший погляд архітектура кеша Nehalem
нагадує Barcelona, але робота кеша третього рівня дуже відрізняється від AMD -
вона інклюзивна для всіх нижніх рівнів ієрархії кеша. Це означає, що якщо ядро
спробує отримати доступ до даних, і вони відсутні в кеші L3, то немає
необхідності шукати дані у власних кешах інших ядер - там їх немає. Навпаки,
якщо дані присутні, чотири біта, пов'язані з кожним рядком кеш-пам'яті (один
біт на ядро) показують, чи можуть дані потенційно присутнім (потенційно, але
без гарантії) в нижньому кеші іншого ядра, і якщо так, то в якому.
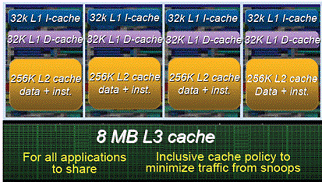
Ця техніка дуже ефективна для забезпечення когерентності персональних кешей кожного ядра, оскільки вона зменшує потребу в обміні інформацією між ядрами. Є, звичайно, недолік у вигляді втрати частини кеш-пам'яті на дані, присутні в кешах інших рівнів. Втім, не все так страшно, оскільки кеші L1 і L2 відносно маленькі в порівнянні з кешем L3 - всі дані кешей L1 і L2 займають, максимум, 1,25 Мбайт в кеші L3 з доступних 8 Мбайт. Як і у випадку Barcelona, кеш третього рівня працює на інших частотах у порівнянні з самим чіпом. Отже, затримка доступу на даному рівні може мінятися, але вона повинна складати близько 40 тактів.
Єдині розчарування в новій ієрархії кеша Nehalem пов'язані з
кешем L1. Пропускна здатність кешу інструкцій не була збільшена - як і раніше
16 байт на такт у порівнянні з 32 у Barcelona. Це може створити "вузьке
місце" в серверно-орієнтованій архітектурі, оскільки 64-бітові інструкції
крупніше, ніж 32-бітові, тим більше що у Nehalem на один декодер більше, ніж у
Barcelona, що сильніше навантажує кеш. Що стосується кеша даних, його затримка
була збільшена до чотирьох тактів в порівнянні з трьома в Conroe, полегшуючи
роботу на високих тактових частотах.
1.4 TLB (Буфер асоціативної трансляції)
Вже багато років процесори працюють не з фізичними адресами пам'яті, а з віртуальними. Серед інших переваг такий підхід дозволяє виділяти програмі більше пам'яті, ніж є в комп'ютері, зберігаючи лише необхідні на даний момент дані у фізичній пам'яті, а все інше - на жорсткому диску. Це означає, що кожен доступ до пам'яті віртуальний адресу потрібно переводити в фізичну адресу, і для збереження відповідності доводиться використовувати величезну таблицю. Проблема в тому, що ця таблиця виходить настільки великий, що на чіпі її зберігати вже не виходить - вона розміщується в основній пам'яті, причому її можна навіть скидати на жорсткий диск (частина таблиці може бути відсутнім в пам'яті, будучи скинутої на HDD).
Якщо для кожної операції роботи з пам'яттю був би потрібний такий етап перекладу адрес, то все працювало б занадто повільно. Тому інженери повернулися до принципу фізичної адресації, додавши невелику кеш-пам'ять безпосередньо на процесор, яка зберігає відповідність для декількох недавно запитаних адрес. Кеш-пам'ять називається Translation Lookaside Buffer (TLB). Intel повністю переробила TLB в новій архітектурі. До цих пір Core 2 використав TLB першого рівня дуже маленького розміру (16 записів), але дуже швидкий і тільки для завантажень, а також більший кеш TLB другого рівня (256 записів), який відповідав за завантаження, відсутні в TLB L1, а також і запису.тепер оснастити повноцінним дворівневим TLB: кеш TLB першого рівня розділений для даних і інструкцій. Кеш TLB L1 для даних може зберігати 64 записи для маленьких сторінок (4K) або 32 записи для великих сторінок (2M/4M), а кеш TLB L1 для інструкцій може зберігати 128 записів для маленьких сторінок (як і у випадку Core2), а також сім для великих. Другий рівень складається з уніфікованого кеша, який може зберігати до 512 записів і працює тільки з маленькими сторінками. Мета такого поліпшення полягає в збільшенні продуктивності додатків, які використовують великі масиви даних. Як і у випадку дворівневої системи передбачення розгалужень, перед нами ще одне свідчення серверної орієнтації архітектури.
Давайте на час повернемося до SMT, оскільки ця технологія теж
впливає на TLB. Кеш L1 TLB для даних і TLB L2 динамічно розподіляються між
двома потоками. Навпаки, кеш L1 TLB для інструкцій статично розподіляється для
малих сторінок, а виділений для великих сторінок повністю копіюється - це
цілком зрозуміло, враховуючи його малий розмір (сім записів на потік).